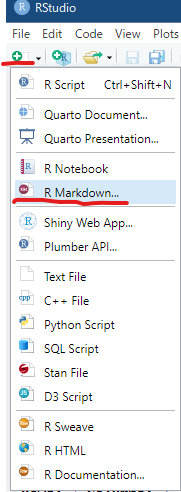
+ボタンを押下し、「R Markdown」をクリック。
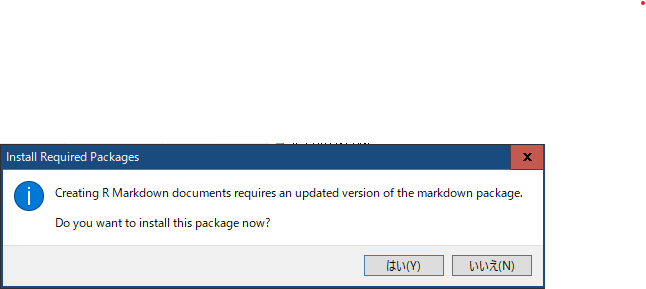
Packageがインストールされていない場合はインストールの有無を聞かれる。「OK」をクリック。
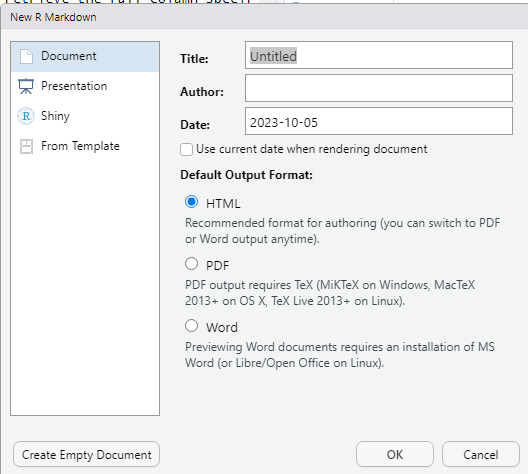
題名、著者、日時の記述、フォーマットを選ぶことができる。(形式はhtml,pdf,wordがある)
| 関数名 | 引数 | 説明 |
|---|---|---|
| 操作関数 | ||
| demo() | デモを見る | |
| help() | オンラインヘルプをみる | |
| help.start() | htmlブラウザによるヘルプをみる | |
| q() | Rを終了 | |
| 統計関数 | ||
| c(数値1,数値2,数値3,数値4) | ベクトルを作る関数 | |
| concatenate() | 連結する。 | |
| var() | ||
| mean() | 平均値を返す | |
| count() | ベクトルの要素数を返す | |
| abs() | 絶対値を返す | |
| sqrt() | 平方根を返す | |
| exp() | 指数値 | 指数関数、eのべき乗を返す |
| log() | 自然対数 | |
| log10() | 常用対数 | |
| ls() | オブジェクト一覧 | |
| round(小数,桁数) | 小数を桁数に指定した位以下を切り捨てる | |
| list(要素1,要素2,要素3) | それぞれの要素にnamesで名前を付けることができる。名前で要素を呼び出す場合は先頭に$をつける。 | |
| data.frame(要素1,要素2,要素3) | データフレームを定義する。データフレームは同じ長さ、型の異なるベクトルを複数格納した物。名前=変数で名前を指定してベクトルを格納する。 | |
| names() | list | listの各要素に名前を付ける。又は名前を取得する |
| sum() | 合計値を返す | |
| length() | 引数の格納数を返す。 | |
| library() | パッケージの読み込み | |
| read.csv() | csvファイルを読み込み | |
| read.table() | txtファイルを読み込み | |
| view() | ||
| table() | テーブルを作成 | |
| prop.table() | テーブル,度数の形式 | 割合を計算する。第二引数無で全体度数、1で行の周辺度数、2で列の周辺度数。 |
| addmargins() | 第二引数無で全体度数、1で行の周辺度数、2で列の周辺度数。表に合計を追加する | |
| var() | ||
| cor() | 相関、分散、共分散を計算する。 | |
| summary() | テーブルを読み取ると、5数要約の値が計算される。 | |
| stat_function | ||
| numeric() | 引数に指定した数量の、配列を定義する。既定値は0で埋められる。 | |
| t.test() | alternative:"two.sided"で両側、"greater"又は"less"で片側 | 検定を行う。 |
| var.test() | 分散分析 | |
| cor.test(x,y) | 相関の検定 | |
| パッケージ | ||
| install.packages("tidyverse") | ||
| tibble() | データフレームの改良版。 | |
| read_table() | textファイルを読み込み | |
| read_csv() | csvファイルを読み込み | |
| read_tsv() | tsvファイルを読み込み | |
| install.packages("knitr") | ||
| library(readr) | ||
| library(ggplot2) | グラフを作成するためのライブラリ | |
| 演算子 | 説明 | 例 |
|---|---|---|
| + | 足し算 | a + b |
| - | 引き算 | a - b |
| * | 掛け算 | a * b |
| / | 割り算 | a / b |
| %% | 余り | a%%b |
| ^ | べき | a^b(aのb乗) |
| 記述 | 説明 |
|---|---|
| 変数名 <- オペラント | |
| 変数名 <- c(数値1,数値2,数値3,数値4) | |
| 数値(小):数値(大) | 数値(小)から数値(大)までを指定 |
| # コメント | コメントアウト |
| 名称 | 説明 |
|---|---|
| ベクトル | |
| リスト | |
| データフレーム | |
| ファクター | 何種類かの可能性のある値 |
| Rスクリプト | .R拡張子のファイル。Rの記述を格納する。 |
| porb | 確率のこと |
| 記述 | 引数 | 説明 |
|---|---|---|
| library(ggplot2) | グラフを作成するためのライブラリ | |
| ggplot(表,aes関数) | グラフのデータを指定 | |
| geom_point() | 散布図。記述:ggplot(変数,aes(x=名前,y=名前)) + geom_point() | |
| geom_line() | color=2で赤線 | 折れ線グラフ。 |
| geom_bar() | 棒グラフ(円グラフ)。記述:ggplot(変数,aes(x=A,y=B)) + geom_bar(stat="identity")列の値をそのままグラフにする場合stat="identity"、何も入れないと集計される | |
| geom_histogram() | ヒストグラム。記述 | |
| geom_box() | 箱髭図 | |
| stat_smooth() | 回帰曲線 | |
| theme() | 背景など | |
| aes(x=名前,y=名前) | グラフ作成時にグラフのx軸、y軸を決めることができる。 | |
+ボタンを押下し、「R Markdown」をクリック。
Packageがインストールされていない場合はインストールの有無を聞かれる。「OK」をクリック。
題名、著者、日時の記述、フォーマットを選ぶことができる。(形式はhtml,pdf,wordがある)
| 記述 | 説明 |
|---|---|
| # | 見出し |
| ## | もう一つ小さい見出し |
| ```{r 名前 オプション} ``` | Rのコードを記述する場所を表す、名前はchunkと言う。(オプションは、echo=boolでRの手順の表示有無、message=boolでメッセージの表示有無、warning=boolで警告の表示有無を定めることができる。 |
| 名称 | 説明 |
|---|---|
| 行の周辺度数 | 各行の合計値を右側に示したもの |
| 列の周辺度数 | 各列の合計値を下側に示したもの |
| 相対度数 | 割合による周辺度数。合計が1となる。列、行、全体の度数による相対度数が定められうる。 |
| シンプソンのパラドックス | |
データから集団の性質を記述し要約する。(代表値、グラフ、表)
データの奥の母集団の特徴を推測する。(推定・検定・実験計画)
調べる対象項目、質的変数と量的変数
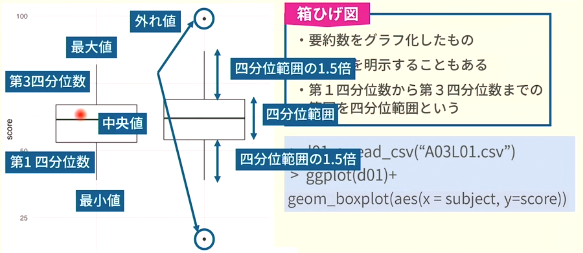
要約数をグラフ化した物
第1四分位数から第3四分位数までの範囲をという
相関関係があるからと言って、因果関係があるわけではないことには注意が必要。
確率:偶然に起こる事象の起こりやすさ。(定義は複数ある)
コルモゴロフの公理:事象Aについて次の3つの性質を満たす関数P(A)を確立という。
ある事象において変数Xの取りうる値の確率が与えられているとき確率変数という。さいころをふる場合は( P(X=1)=1/6 )と書く。
事象Aが起こったという条件の元で事象Bが起こる確率を条件付き確率という。これをP(B|A)とすると、
P(B|A) = P(A∩B)/P(A)
確率の乗法定理:P(A∩B)=P(B|A)P(A)が成り立つ
独立性:P(A∩B) = P(A)P(B)の時、事象AとBは独立である。(独立・・・事象Aが起こったことが事象Bの起こる確率に影響しない)
ベイズの定理:ある確率で選択されるいくつかのパターンの内、それぞれ異なる確率で同一の事象が起こるとすると、その事象が一つのパターンで起こる確率から、その一つのパターンを含む全パターンでその事象が起こる確率をそれぞれ足し合わせた確率で割ったものが、一つのパターンでその事象が起こる確率である。
トップへ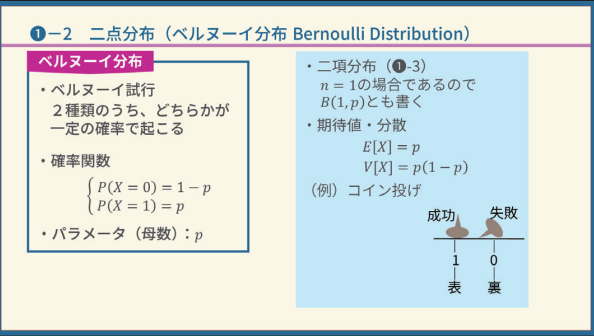
| 関数 | 意味 | 例 |
|---|---|---|
| dXXXX | 確率密度関数(確率関数) | |
| pXXXX | 累積分布関数 | |
| qXXXX | 逆分布関数 | |
| rXXXX | 乱数 | |
| 離散型(上記のXXXXに入る物) | ||
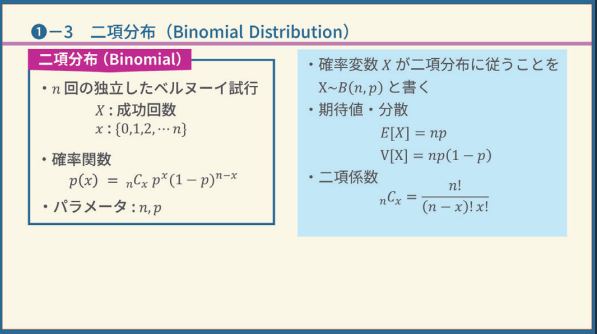
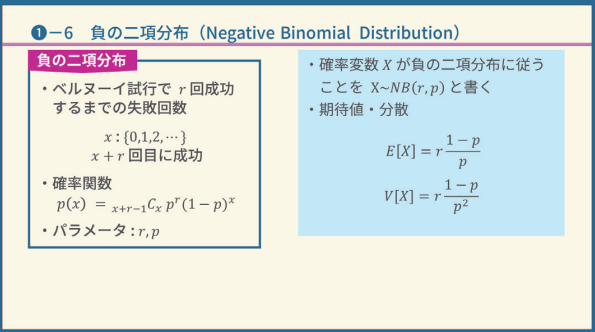
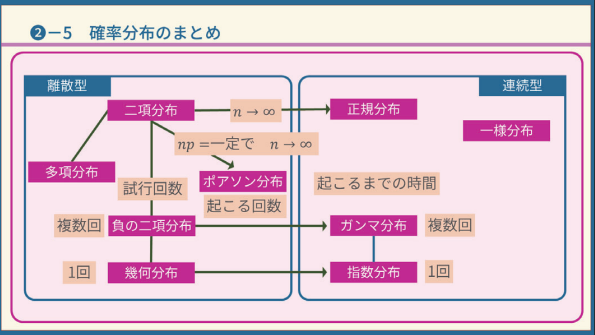
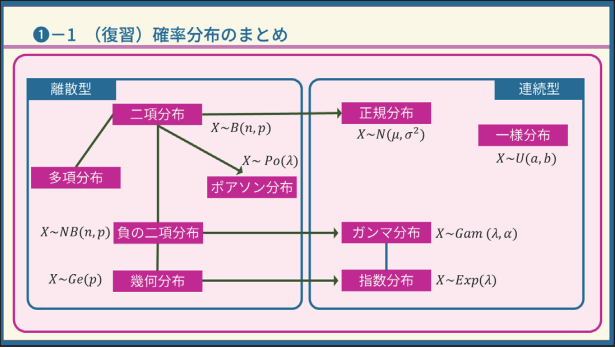
| binom | 二項分布 | dbirom(x,n,p) |
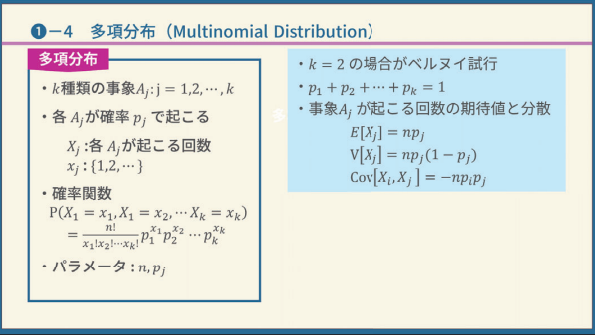
| multinom | 多項分布 | dmultinom(c(x1,x2),n,c(p1,p2)) |
| nbinom | 負の二項分布 | |
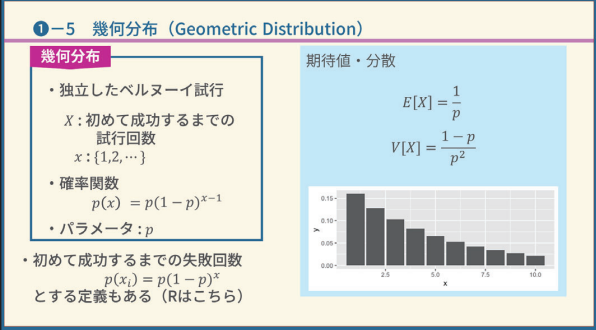
| geom | 幾何分布 | |
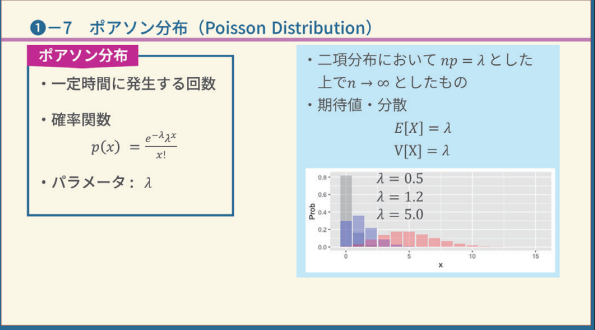
| pois | ポアソン分布 | |
| 連続型 | ||
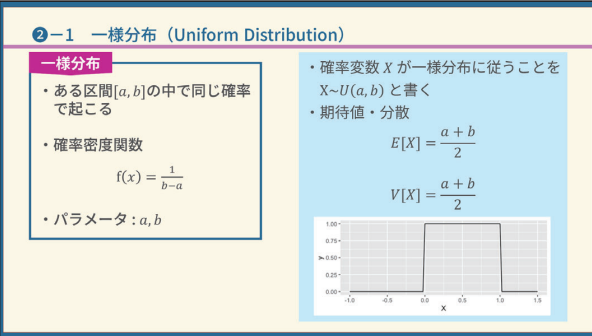
| unif | 一様分布 | dunif(x,min,max) |
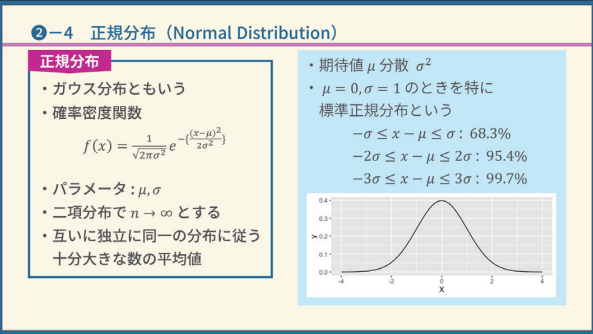
| norm | 正規分布 | dnorm(x,mean,sd) |
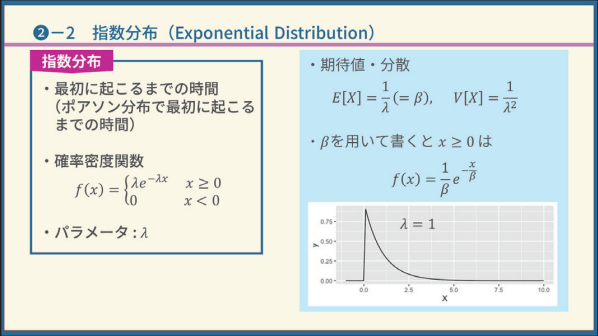
| exp | 指数分布 | dexp(x,rate) |
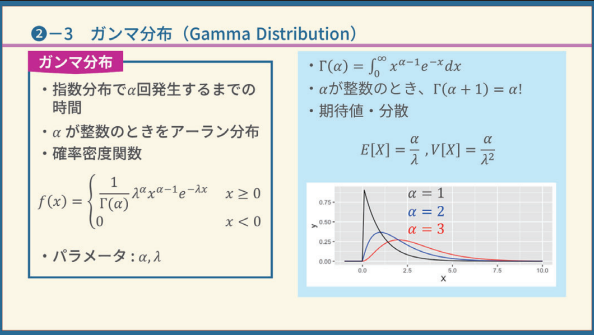
| gamma | ガンマ分布 | dgamma(x,shape,rate) |
二項分布:dbinom(回数,試行数,確率)
正規分布:pnorm(範囲(正の数),平均,標準偏差)
ガンマ分布:pgamma(時間,平均λ,回数)
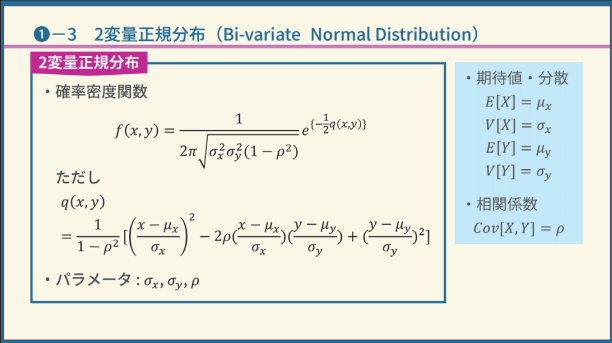
再生性:2つの確率変数X,Yが独立で、どちらも同じ確率分布に従うとするときに和X+Yも同じ確率分布になるとき、再生性を持つという。
無記憶性:ある時刻(ステップ)s(m回)までに何も起こらなかった条件の下でその後の時刻(ステップ)[s,s+t](n+m回まで)に起こらない確率。今まで起こらなかったといおう条件は、これからの条件に影響を与えない。
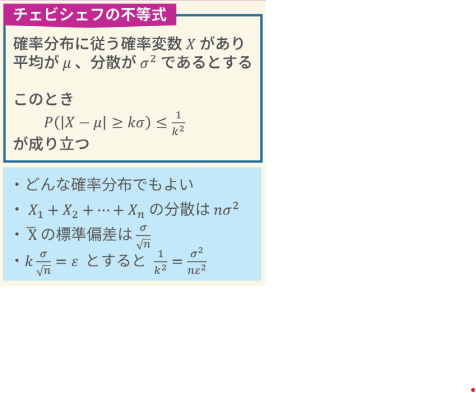
| 関数 | 意味 | 例 |
|---|---|---|
| dXXXX | 確率密度関数(確率関数) | |
| pXXXX | 累積分布関数 | |
| qXXXX | 逆分布関数 | |
| rXXXX | 乱数 | |
| 連続型の関数 | ||
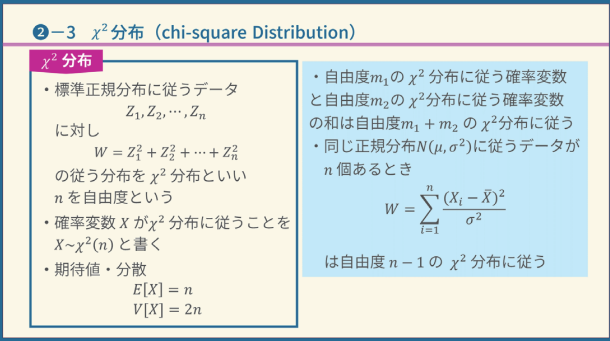
| chisq | χ^2分布 | dchisq(x,df) |
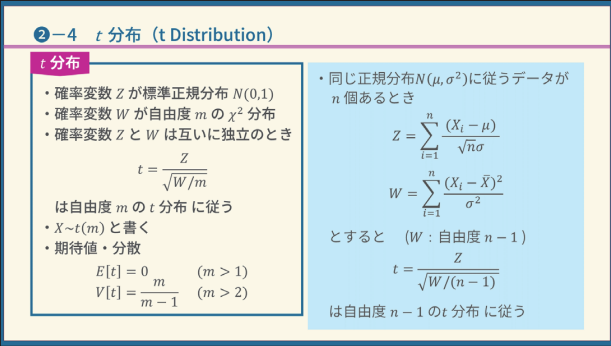
| t | t分布 | dbinom(x,df) |
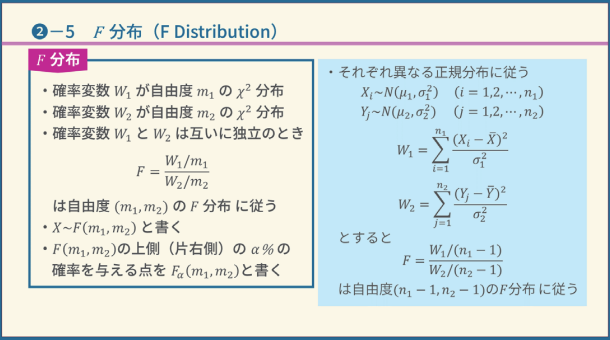
| F | F分布 | dF(x,df1,df2) |
データから集団の性質を記述し要約する。代表値グラフ、表。
データの奥の母集団の特徴を推測する。推定・検定・実験計画。母集団があるパラメータをもっていると仮定して推測。
調べる対象となる全体
分布を特徴づける定数
母集団から抽出された部分集合
標本から計算される量(標本平均、標本分散等)
偏りなく母集団の特徴を反映するように抽出したい
何か介入をし効果を調べる。実験群と対照群を比較
介入が行えない。無作為化が行えない
同じ条件で複数回反復。ばらつきの要因を知る
条件が複数あるときにランダムに割り当てる
条件が同じ複数のブロックに分割
全体から無作為に抽出
性別や地域といった層ごとに抽出層によるばらつきを減らす
特徴毎に少数の集団(クラスター)に分けて、いくつかのクラスターを抽出、選ばれたクラスターには全数調査
観測数nを無限にしたときに推定値がパラメータに確率収束する
推定量の期待値がパラメータと一致
推定量の分散を最小にするもの
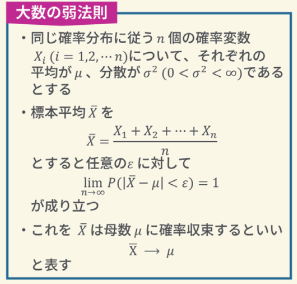
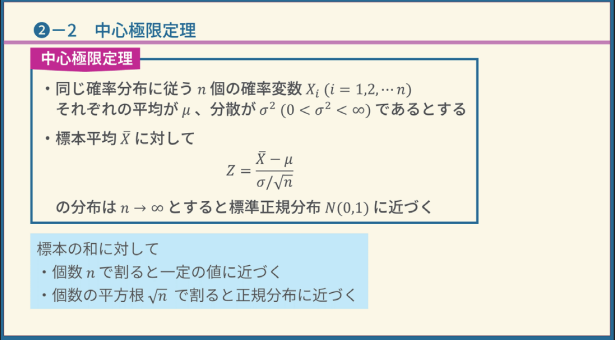
N個の確率変数があってそれぞれ独立に同じ確率分布に従うと、標本平均は期待値に一致する。
何かを判断するには2つの過ちがある。
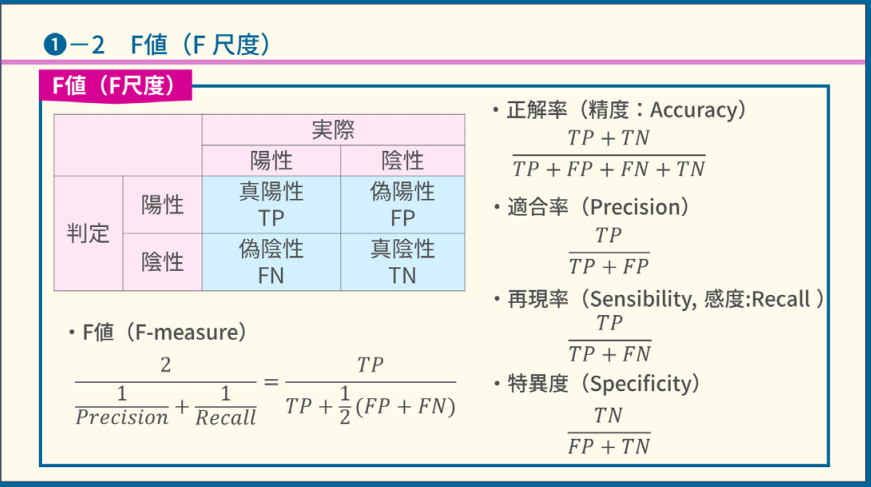
| 実際 | |||
|---|---|---|---|
| 陽性 | 陰性 | ||
| 判定 | 陽性 | 真陽性TP(True Positive) | 偽陽性 FP(False Positive) |
| 陰性 | 偽陰性 FN(False Negative) | 真陰性 TN(True Negative) | |
F値(F-measure)
ある仮説を仮定し、そのもとで標本が抽出される確率を計算する事前に定めた基準よりも低い場合にその仮説を正しくないと判断する
平均と分散が既知の正規分布に従うデータから取り出された標本の標本平均が既知の平均と異なるかどうかを検定する場合、等しいときにはスチューデントの t 検定、そうでないときにはウェルチの t 検定を行います。
| 用語 | 意味 |
|---|---|
| paired | 対応があるかどうか。bool型 |
| var.equal | 等分散かどうか。bool型 |
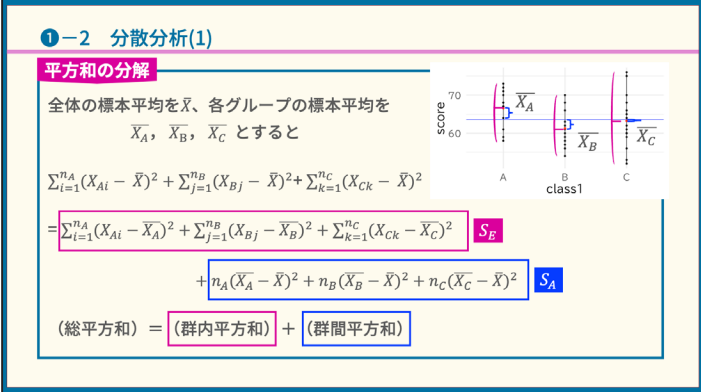
(総平方和)=(郡内平方和)+(群間平方和)
観測度数が正規分布に従うとして、観測度数と期待度数の差を2乗したものを期待度数で割った値をすべて足したものが近似的にカイ2乗分布に従うことを利用して検定を行っている。
イエーツの補正